Claude Sonnet 5.5-მა სააგენტო ამოცანებში Opus 5.5-ს დაეწია, თუმცა ერთი დათქმით
Anthropic-მა გამოუშვა Claude Sonnet 5.5 — საშუალო დონის მოდელი, რომელიც მთელ რიგ სააგენტო ბენჩმარკებში ფლაგმანურ Opus 5.5-ს გაუთანაბრდა ან გადაუსწრო კიდეც. ფასი Sonnet 5-ის დონეზე დარჩა — 2$ მილიონ შემავალ და 10$ მილიონ გამომავალ ტოკენზე, რაც ორჯერ იაფია Opus 5.5-ზე. კომპანიის განცხადებით, მოდელი…
Anthropic-მა გამოუშვა Claude Sonnet 5.5 — საშუალო დონის მოდელი, რომელიც მთელ რიგ სააგენტო ბენჩმარკებში ფლაგმანურ Opus 5.5-ს გაუთანაბრდა ან გადაუსწრო კიდეც. ფასი Sonnet 5-ის დონეზე დარჩა — 2$ მილიონ შემავალ და 10$ მილიონ გამომავალ ტოკენზე, რაც ორჯერ იაფია Opus 5.5-ზე. კომპანიის განცხადებით, მოდელი წინამორბედზე 30%-ზე მეტად სწრაფად მუშაობს და თითო ამოცანაზე გადაანგარიშებით 30%-მდე იაფი ჯდება. ქვემოთ გიზიარებთ ჩემს მოსაზრებას ამ სიახლესთან დაკავშირებით.
რას აჩვენებს ციფრები
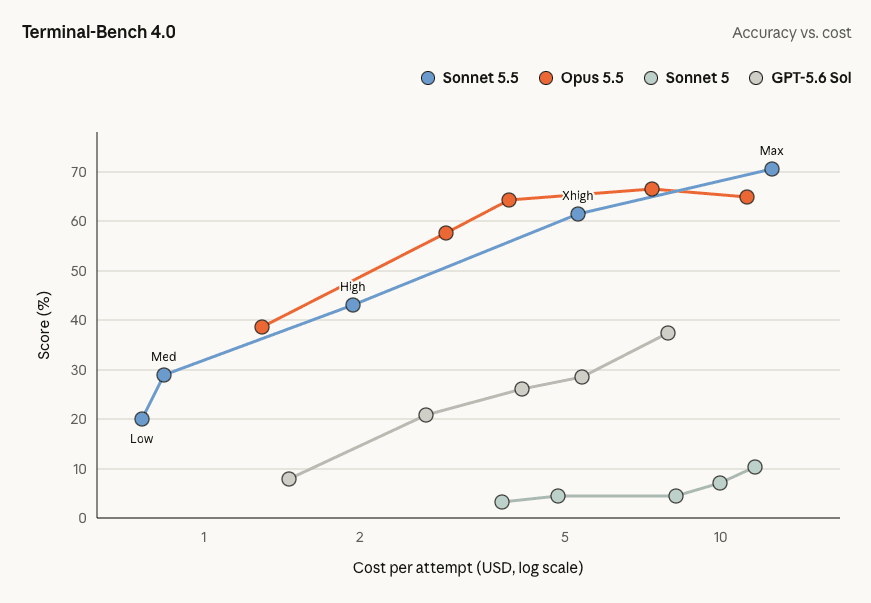
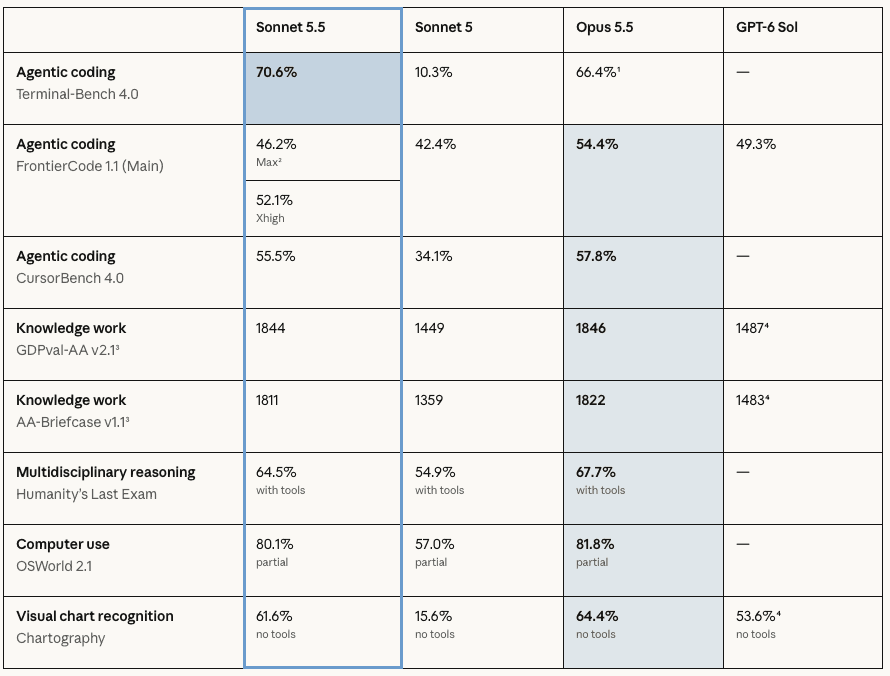
Anthropic-ის საკუთარი შედეგები ასე გამოიყურება: Terminal-Bench 4.0-ზე (სააგენტო პროგრამირება ტერმინალში) Sonnet 5.5 აგროვებს 70,6%-ს Opus 5.5-ის 66,4%-ის წინააღმდეგ.
OSWorld 2.1-ზე (კომპიუტერის მართვა) — 80,1% 81,8%-ის წინააღმდეგ. GDPval-AA-ში, გამოყენებითი „საოფისე“ სამუშაოს ტესტში, სხვაობა თითქმის გაქრა: 1 844 ქულა Sonnet 5.5-ს, Opus 5.5-ის 1 846-ისა და Sonnet 5-ის 1 449-ის წინააღმდეგ.
დამოუკიდებელმა ლაბორატორიამ Artificial Analysis, რომელიც მოდელების ერთ-ერთ ყველაზე ციტირებად შემაჯამებელ რეიტინგს აწარმოებს, Sonnet 5.5 მეორე ადგილზე დააყენა თავის Intelligence Index-ში 56 ქულით. მასზე წინ მხოლოდ Opus 5.5-ია (58), ხოლო OpenAI-ის GPT-6 Astra 53 ქულით მესამე ადგილს Fable 5.1-თან იყოფს. ზრდამ Sonnet 5-თან შედარებით 18 პუნქტი შეადგინა.
გაზომვებში აბსოლუტური მნიშვნელობები განსხვავდება. Artificial Analysis-ის ტესტირებაში Terminal-Bench 4.0-ზე Sonnet 5.5-მა მიიღო 63,6%, ხოლო Opus 5.5-მა — 59,6%. მოდელების თანმიმდევრობა ემთხვევა Anthropic-ის მონაცემებს, თუმცა ორივე ციფრი დაახლოებით შვიდი პუნქტით დაბალია, რაც ტიპურია სააგენტო ინფრასტრუქტურის კონფიგურაციებს შორის სხვაობისთვის.
რაშია ხაფანგი
შეუსაბამობა ღირებულებას ეხება. Anthropic გვპირდება 30%-მდე ეკონომიას თითო ამოცანაზე. Artificial Analysis-მა კი დათვალა, რომ ძალისხმევის მაქსიმალურ დონეზე Sonnet 5.5 ხარჯავს დაახლოებით 193 000 გამომავალ ტოკენს თითო ამოცანაზე. ეს დაახლოებით 60%-ით მეტია, ვიდრე Opus 5.5-ის ან Sonnet 5-ის მაჩვენებელი მათ მაქსიმალურ პარამეტრებზე, და თითო ამოცანაზე 7,60$-ს შეადგენს — რაც დაახლოებით 50%-ით ძვირია Sonnet 5-ზე.
ორივე მხარე სხვადასხვა რეჟიმს ზომავს. VentureBeat-ის მონაცემებით, Sonnet 5.5 დაბალი და საშუალო დონის ძალისხმევისას ეწევა Sonnet 5-ის საუკეთესო შედეგს დაახლოებით მეათედ ფასად. ეკონომია რეალურია ზომიერ პარამეტრებზე, ხოლო მაქსიმალური რეჟიმი ხარისხის ბოლო ქულებს ძალიან ძვირი ტოკენების ხარჯზე ყიდულობს.
სუსტი წერტილებიც თვალსაჩინოა. AA-Omniscience-ზე, ფაქტობრივი ცოდნის ტესტში, Sonnet 5.5 აჩვენებს 54%-ს Opus 5.5-ის 66%-ის წინააღმდეგ, სამეცნიერო მსჯელობაში კი დაახლოებით ექვსი პუნქტით ჩამორჩება. მოდელი ძლიერია მოქმედებაში და შედარებით სუსტი — ერუდიციაში.
უსაფრთხოება და დაცვა დისტილაციისგან
Sonnet 5.5 გახდა Sonnet-ის ხაზის პირველი მოდელი ფრონტირული (frontier) მოდელების დონის კიბერდაცვით. Anthropic-ის განცხადებით, კიბერშესაძლებლობების ზრდა იმდენად დიდია, რომ მოითხოვს ზუსტად იმავე შეზღუდვებს, როგორსაც Opus 5.5. გაჩნდა კლასიფიკატორებიც, რომლებიც ბლოკავს მსჯელობის ჯაჭვების ამოღებას. ეს არის პასუხი დისტილაციაზე — როდესაც კონკურენტები საკუთარ მოდელებს სხვების მსჯელობაზე წვრთნიან — და მკვლევრების ბოლოდროინდელ ნაშრომზე, რომლებმაც აგენტების 6 708 საჯარო ტრასიდან გაშიფრეს „აზროვნების“ 315 320 ბლოკი და იქიდან ავტორიზაციის მონაცემები და გასაღებები ამოიღეს.
რას იძლევა ეს პერსპექტივაში
პროდუქტული სცენარების უმრავლესობისთვის Sonnet 5.5 ზედმეტად აქცევს Opus 5.5-ს. ინდექსში ორქულიანი სხვაობა არ ამართლებს ტოკენის ორმაგ ფასს. ეკონომიის მთავარი ბერკეტი ახლა effort პარამეტრია. ნაგულისხმევად მაქსიმუმზე გაშვება მარტივად ამოწურავს მთელ ლიმიტს, ამიტომ უახლოეს კვირებში ღირს საკუთარი eval-ტესტების low და medium რეჟიმებზე გატარება და დონის აწევა მხოლოდ იქ, სადაც ხარისხი ნამდვილად იკლებს.